بیشبرازش یا Overfitting چیست و چگونه از آن جلوگیری کنیم؟
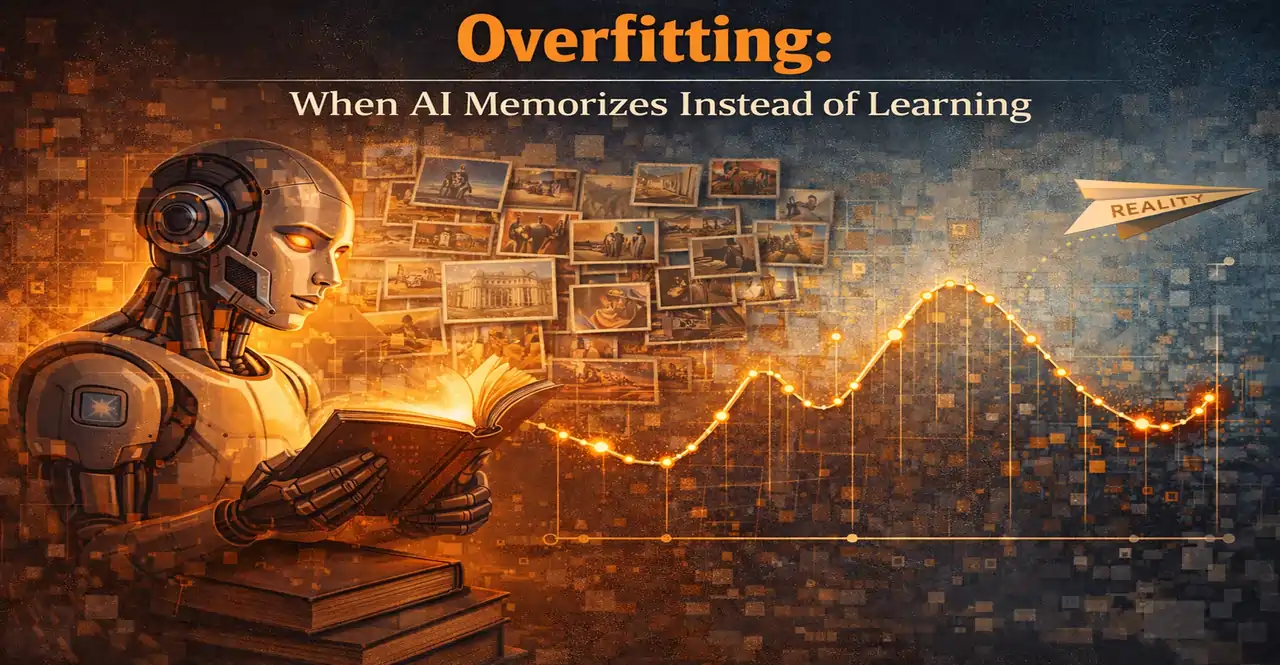
🎯 بیش برازش: کابوس مدل های هوشمند و راهکارهای غلبه بر آن
آیا تا به حال شنیده اید که یک مدل هوش مصنوعی در محیط آزمایشگاهی عالی عمل کند، اما در دنیای واقعی کاملاً شکست بخورد؟ این همان چیزی است که به آن بیش برازش می گویند؛ پدیده ای رایج که می تواند نتایج تلاش های شما را بی اثر کند. در این مقاله، عمیقاً به این چالش می پردازیم و راهکارهای عملی برای جلوگیری از آن را کشف می کنیم.
🎯 پاسخ سریع
بیش برازش یا Overfitting زمانی رخ می دهد که یک مدل یادگیری ماشین به جای یادگیری الگوهای کلی، جزئیات و نویزهای داده های آموزشی را حفظ کند. این باعث می شود مدل در داده های جدید عملکرد ضعیفی داشته باشد. برای جلوگیری از آن باید از تکنیک هایی مانند افزایش داده، رگولاریزیشن و توقف زودهنگام استفاده کرد.
در دنیای هیجان انگیز آموزش machine learning و هوش مصنوعی، ساخت مدل هایی که بتوانند تصمیمات دقیق و هوشمندانه بگیرند، هدف اصلی ماست. اما این مسیر همیشه هموار نیست و چالش های زیادی در پیش رو داریم. یکی از مهم ترین و رایج ترین این چالش ها، پدیده ای است که به آن «بیش برازش» یا «Overfitting» می گویند. شاید برای شما هم پیش آمده باشد که یک مدل با دقت ۹۹٪ روی داده های آموزشی خود کار می کند، اما وقتی با داده های جدید و ناشناخته روبرو می شود، عملکردی فاجعه بار از خود نشان می دهد. این دقیقاً همان لحظه ای است که مدل شما دچار بیش برازش شده است. در این مقاله قصد داریم به طور جامع به این مفهوم بپردازیم، علت های اصلی وقوع آن را بررسی کنیم و مهم تر از همه، راهکارهای عملی و اثبات شده ای را برای جلوگیری از آن ارائه دهیم تا مدل های شما بتوانند در دنیای واقعی نیز به خوبی تعمیم پیدا کنند و کارایی لازم را داشته باشند. با ما همراه باشید تا با درک عمیق این پدیده، ابزارهای لازم برای ساخت مدل های قدرتمندتر و قابل اعتمادتر را به دست آورید.
📌 نکات کلیدی
• بیش برازش، حفظ نویزهای داده های آموزشی است، نه یادگیری الگوهای کلی • هدف، ساخت مدلی است که در داده های دیده نشده هم خوب عمل کند • تکنیک های متعددی برای مقابله با Overfitting وجود دارد.
📘 بیش برازش (Overfitting) چیست؟ (به زبان ساده)
برای درک مفهوم بیش برازش، بیایید یک مثال ساده بزنیم. تصور کنید می خواهید به یک کودک یاد دهید که سگ ها را از گربه ها تشخیص دهد. اگر فقط عکس سگ های خانگی خودتان را به او نشان دهید، ممکن است کودک فقط سگ هایی با نژاد خاص و رنگ مشخص را سگ بداند و نتواند سگ های دیگر نژادها یا حتی سگ هایی با رنگ های متفاوت را تشخیص دهد. این کودک به جای یادگیری ویژگی های کلی سگ بودن (مثل پوزه، دم، پارس کردن)، جزئیات خاص سگ های شما را حفظ کرده است. این همان اتفاقی است که در بیش برازش برای مدل های یادگیری ماشین می افتد.
در واقع، بیش برازش زمانی رخ می دهد که یک مدل هوش مصنوعی بیش از حد روی داده های آموزشی خود حفظ شود. به جای اینکه الگوهای اساسی و روابط کلی موجود در داده ها را یاد بگیرد، شروع به یادگیری نویزها، خطاهای تصادفی و جزئیات بی ربطی می کند که فقط در مجموعه داده آموزشی او وجود دارند. نتیجه این می شود که مدل در محیط آموزش خود عملکرد فوق العاده ای دارد (مثلاً دقت ۹۹٪)، اما وقتی با داده های جدید، واقعی و ندیده شده مواجه می شود، به شدت عملکردش افت می کند و پیش بینی های نادرستی انجام می دهد. این یعنی مدل توانایی تعمیم (Generalization) خود را از دست داده است. هدف اصلی ما در یادگیری ماشین، ساخت مدل هایی است که بتوانند از داده های آموزشی به خوبی تعمیم پیدا کرده و در مواجهه با داده های جدید نیز دقیق عمل کنند.
📘 چرا مدل های ما بیش برازش می شوند؟ (دلایل اصلی)
درک دلایل بیش برازش، کلید جلوگیری از آن است. این پدیده معمولاً نتیجه ترکیبی از چند عامل است که در ادامه به بررسی آن ها می پردازیم:
|
1️⃣
پیچیدگی مدلمدل خیلی قدرتمند |
2️⃣
کمبود دادهآموزش روی داده کم |
3️⃣
نویز در داده هاداده های پر از خطا |
4️⃣
ویژگی های غیرضروریورودی های اضافی |
پیچیدگی بیش از حد مدل (High Variance)
گاهی اوقات، مدلی که برای حل یک مسئله انتخاب می کنیم، بیش از حد قدرتمند یا پیچیده است. مثلاً، برای یک مسئله ساده که با یک خط مستقیم قابل حل است، از یک شبکه عصبی عمیق با لایه های زیاد استفاده می کنیم. این مدل بیش از حد توانایی یادگیری دارد و به جای پیدا کردن الگوی ساده، سعی می کند تمام نقاط داده آموزشی را به هر قیمتی به هم وصل کند، حتی اگر این کار به معنی ترسیم یک مسیر بسیار پر پیچ و خم باشد. این پیچیدگی باعث می شود مدل به نوسانات و جزئیات کوچک در داده های آموزشی حساس شود و در نتیجه، واریانس بالایی داشته باشد.
کمبود داده های آموزشی
اگر مدل را با حجم کمی از داده ها آموزش دهیم، احتمال بیش برازش به شدت افزایش می یابد. داده های کم، تنوع کافی از جهان واقعی را به مدل ارائه نمی دهند. مدل با این داده های محدود، نمی تواند الگوهای کلی را به خوبی یاد بگیرد و به جای آن، جزئیات خاص این نمونه های محدود را حفظ می کند. به عبارت دیگر، مثل این است که به همان کودک فقط یک عکس از سگ خودتان را نشان دهید و انتظار داشته باشید همه سگ ها را تشخیص دهد.
وجود نویز در داده ها
داده های دنیای واقعی اغلب حاوی نویز یا اطلاعات بی ربط و اشتباه هستند. اگر مدل بیش از حد پیچیده باشد و به اندازه کافی داده برای آموزش نداشته باشد، ممکن است شروع به یادگیری این نویزها به عنوان الگوهای واقعی کند. این نویزها در داده های آموزشی وجود دارند، اما در داده های جدید دیده نمی شوند و باعث افت عملکرد مدل می شوند.
📘 چگونه بفهمیم مدل دچار بیش برازش شده است؟ (راه های شناسایی)
شناسایی به موقع بیش برازش، اولین قدم برای رفع آن است. خوشبختانه، چند روش کلیدی وجود دارد که به ما کمک می کند این پدیده را تشخیص دهیم:
🔄 چطور تشخیص دهیم
|
1
آموزش و تست |
2
نمودار هزینه |
3
اعتبارسنجی |
4
تحلیل خطا |
مقایسه دقت آموزش (Training) و اعتبارسنجی (Validation)
این رایج ترین و ابتدایی ترین روش تشخیص بیش برازش است. شما معمولاً داده های خود را به دو بخش تقسیم می کنید: داده های آموزشی (Training Data) که مدل با آنها یاد می گیرد و داده های اعتبارسنجی (Validation Data) که مدل برای اولین بار روی آنها تست می شود. اگر مشاهده کردید که دقت مدل روی داده های آموزشی بسیار بالا (مثلاً ۹۸٪) است، اما همان مدل روی داده های اعتبارسنجی عملکرد به مراتب ضعیف تری (مثلاً ۷۰٪) دارد، این یک نشانه قوی از بیش برازش است. مدل در حال تقلب روی داده های آموزشی است و توانایی تعمیم به داده های جدید را ندارد.
تحلیل نمودار تابع هزینه (Loss Curve)
در طول فرآیند آموزش مدل، معمولاً نمودارهایی از تابع هزینه (Loss Function) یا خطا (Error) رسم می شود. این نمودارها، خطای مدل را هم برای داده های آموزشی و هم برای داده های اعتبارسنجی نشان می دهند. در یک حالت ایده آل، هر دو نمودار خطا باید همزمان کاهش یابند. اما اگر مشاهده کردید که خطای آموزش همچنان در حال کاهش است، در حالی که خطای اعتبارسنجی پس از یک نقطه شروع به افزایش می کند، این نیز نشانه ای واضح از بیش برازش است. مدل در حال بهینه کردن خود برای نویزهای داده آموزشی است که به ضرر عملکرد واقعی آن تمام می شود.
📘 تکنیک های طلایی برای جلوگیری از بیش برازش
خوشبختانه، جامعه یادگیری ماشین راهکارهای متعددی برای مقابله با بیش برازش ابداع کرده است. انتخاب بهترین تکنیک به ماهیت مسئله، حجم داده ها و نوع مدل بستگی دارد. در ادامه به برخی از موثرترین آنها اشاره می کنیم:
|
🧭
مدیریت داده |
✅
تعدیل مدل |
⚡
بهینه سازی آموزش |
افزایش داده های آموزشی (Data Augmentation)
یکی از موثرترین روش ها، داشتن داده های بیشتر است. اما همیشه امکان جمع آوری داده های جدید وجود ندارد. در این مواقع، تکنیک افزایش داده به کمک ما می آید. به عنوان مثال، در کار با تصاویر، می توانیم با اعمال تغییراتی مانند چرخش، برش، تغییر اندازه، روشنایی یا معکوس کردن تصاویر موجود، نمونه های جدید و متنوعی تولید کنیم. این کار باعث می شود مدل با نسخه های مختلفی از یک داده واحد آموزش ببیند و کمتر به جزئیات خاص یک نمونه تکی وابسته شود.
انتخاب ویژگی های کلیدی (Feature Selection)
گاهی اوقات، مدل با ویژگی های بیش از حد یا نامربوط آموزش می بیند. این ویژگی های اضافی می توانند نویز ایجاد کنند و باعث شوند مدل به جای تمرکز بر اطلاعات مهم، روی جزئیات بی اهمیت حساس شود. انتخاب ویژگی به فرآیند شناسایی و حفظ تنها مهم ترین و مرتبط ترین ویژگی ها برای آموزش مدل اشاره دارد. با کاهش تعداد ویژگی ها، پیچیدگی مدل نیز کاهش یافته و احتمال بیش برازش کمتر می شود.
رگولاریزیشن (L1/L2 Regularization)
رگولاریزیشن یک خانواده از تکنیک هاست که با افزودن جریمه به تابع هزینه مدل، از پیچیدگی بیش از حد آن جلوگیری می کند. این جریمه، وزن های مدل را کوچک نگه می دارد و از اینکه مدل به شدت به یک ویژگی خاص وابسته شود، جلوگیری می کند. دو نوع رایج آن L1 (Lasso) و L2 (Ridge) هستند:
- رگولاریزیشن L1: تمایل دارد وزن برخی ویژگی ها را به صفر برساند، که عملاً به معنی حذف آن ویژگی ها از مدل است. این خاصیت باعث می شود L1 به عنوان یک روش انتخاب ویژگی نیز عمل کند.
- رگولاریزیشن L2: وزن ها را به سمت صفر سوق می دهد اما معمولاً آنها را کاملاً صفر نمی کند. این کار باعث می شود مدل به همه ویژگی ها توجه کند اما با وزن های کوچک تر، که به کاهش حساسیت مدل به نویز کمک می کند.
تکنیک Dropout در شبکه های عصبی
در شبکه های عصبی، Dropout یک تکنیک قدرتمند است. در طول هر مرحله آموزش، به طور تصادفی درصدی از نورون ها (واحدها) را در لایه های پنهان شبکه خاموش می کند. این به این معنی است که این نورون ها در آن مرحله خاص آموزش، هیچ نقشی در محاسبات ندارند. با این کار، مدل مجبور می شود به جای وابستگی به یک مجموعه خاص از نورون ها، الگوها را به صورت توزیع شده تر یاد بگیرد و از هم وابستگی (Co-adaptation) نورون ها جلوگیری می کند. Dropout را می توان به عنوان آموزش چندین زیرشبکه مختلف به صورت همزمان در نظر گرفت که در نهایت به یک مدل قوی تر و کمتر مستعد بیش برازش منجر می شود.
توقف زودهنگام (Early Stopping)
همانطور که قبلاً اشاره شد، در نمودار تابع هزینه، ممکن است خطای اعتبارسنجی پس از مدتی شروع به افزایش کند، در حالی که خطای آموزش همچنان کاهش می یابد. توقف زودهنگام به این معنی است که به محض اینکه خطای اعتبارسنجی شروع به افزایش کرد (یا برای چند دوره متوالی افزایش یافت)، فرآیند آموزش را متوقف کنیم. این کار باعث می شود مدل در نقطه ای متوقف شود که بهترین تعادل بین عملکرد روی داده های آموزشی و توانایی تعمیم به داده های جدید را دارد و از بیش برازش جلوگیری می کند.
اعتبارسنجی متقابل (Cross-Validation)
اعتبارسنجی متقابل یک روش قوی برای ارزیابی عملکرد مدل و کاهش احتمال بیش برازش است، به خصوص زمانی که حجم داده ها محدود است. در این روش، مجموعه داده به چند تا (Fold) تقسیم می شود (مثلاً k-fold Cross-Validation). سپس مدل k بار آموزش داده می شود؛ در هر بار، یک تا به عنوان مجموعه اعتبارسنجی و بقیه به عنوان مجموعه آموزشی استفاده می شوند. میانگین عملکرد مدل در این k بار، تخمین قابل اعتمادتری از توانایی تعمیم مدل ارائه می دهد و به ما کمک می کند تا مدل را بدون بیش برازش روی یک زیرمجموعه خاص از داده ها، ارزیابی کنیم.
📘 تفاوت بیش برازش (Overfitting) و کم برازش (Underfitting)
در کنار بیش برازش، مفهوم دیگری به نام کم برازش (Underfitting) نیز وجود دارد که نقطه مقابل آن است. هر دو این پدیده ها به معنی عدم تعمیم صحیح مدل هستند، اما دلایل و نشانه های متفاوتی دارند. درک این تفاوت ها ضروری است تا بتوانیم مشکل را به درستی تشخیص داده و راهکار مناسب را انتخاب کنیم.
|
✅ Overfitting (بیش برازش)
|
⚠️ Underfitting (کم برازش)
|
در حالی که بیش برازش به معنای حفظ کردن و حساسیت زیاد به جزئیات است، کم برازش به معنای یاد نگرفتن الگوهای اساسی است. مدل کم برازش، حتی روی داده های آموزشی خود نیز عملکرد ضعیفی دارد، زیرا به اندازه کافی پیچیده نیست تا بتواند روابط موجود در داده ها را درک کند. برای حل کم برازش، معمولاً باید مدل را پیچیده تر کرد، ویژگی های بیشتری به آن اضافه کرد یا زمان آموزش را افزایش داد، که دقیقاً برعکس راهکارهای بیش برازش است.
📌 جمع بندی
بیش برازش یکی از رایج ترین و مهم ترین چالش ها در توسعه مدل های یادگیری ماشین است. این پدیده می تواند باعث شود مدل هایی که در محیط آموزشی بی نظیر به نظر می رسند، در دنیای واقعی کاملاً بی فایده باشند. همانطور که بررسی کردیم، این مشکل ناشی از پیچیدگی بیش از حد مدل، کمبود داده های آموزشی یا وجود نویز است. با این حال، با استفاده از تکنیک های موثری مانند افزایش داده، انتخاب ویژگی، رگولاریزیشن، Dropout، توقف زودهنگام و اعتبارسنجی متقابل، می توانیم به طور قابل توجهی احتمال بیش برازش را کاهش دهیم و مدل هایی بسازیم که نه تنها دقیق، بلکه قابل اعتماد و با قابلیت تعمیم بالا هستند. درک و به کارگیری این راهکارها، گامی اساسی در مسیر تبدیل شدن به یک متخصص موفق در حوزه هوش مصنوعی و یادگیری ماشین است.
✅ آماده اید مدل هایتان را بهینه کنید؟
برای عمیق تر شدن در مباحث یادگیری ماشین و جلوگیری از خطاهای رایج، دوره های تخصصی ما را بررسی کنید.
مشاهده دوره ها
❓ آیا همیشه افزایش داده های آموزشی مشکل بیش برازش را حل می کند؟
خیر، همیشه اینطور نیست. اگر داده های جدید نیز دارای نویز یا سوگیری مشابه داده های قبلی باشند، یا اگر مدل همچنان بیش از حد پیچیده باشد، افزایش داده به تنهایی ممکن است کافی نباشد. افزایش داده های با کیفیت و متنوع در کنار سایر تکنیک ها موثرتر است.
❓ تفاوت اصلی بین رگولاریزیشن L1 و L2 در چیست؟
L1 (Lasso) می تواند وزن برخی ویژگی ها را دقیقاً به صفر برساند و به عنوان یک روش انتخاب ویژگی عمل کند. در مقابل، L2 (Ridge) وزن ها را به صفر نزدیک می کند اما معمولاً آنها را کاملاً صفر نمی کند و بیشتر بر کاهش کلی اندازه وزن ها تمرکز دارد تا مدل کمتر به یک ویژگی خاص وابسته شود.
❓ چگونه می توانیم از تکنیک Early Stopping در کتابخانه هایی مثل Keras استفاده کنیم؟
در Keras، می توانید از Callback `EarlyStopping` استفاده کنید. این Callback به شما امکان می دهد پارامترهایی مانند `monitor` (معیاری که باید نظارت شود، مثلاً ‘val_loss’)، `patience` (تعداد دوره هایی که می توان بدون بهبود ادامه داد) و `mode` (min/max) را تنظیم کنید تا آموزش به صورت خودکار در زمان مناسب متوقف شود.
❓ آیا بیش برازش در مدل های رگرسیون خطی هم رخ می دهد؟
بله، بیش برازش می تواند در مدل های رگرسیون خطی نیز رخ دهد، به خصوص اگر تعداد ویژگی ها بسیار زیاد باشد (نسبت به تعداد نمونه ها) یا ویژگی های هم خطی (Collinear) وجود داشته باشند. در این حالت نیز مدل می تواند به نویزها حساس شود و خطای واریانس بالا داشته باشد. استفاده از رگولاریزیشن L1 و L2 در رگرسیون خطی (Lasso و Ridge Regression) برای جلوگیری از همین مشکل است.
❓ ساده ترین راه برای تشخیص Overfitting چیست؟
ساده ترین و اولین راه، مقایسه عملکرد مدل روی مجموعه داده آموزشی و مجموعه داده اعتبارسنجی (یا تست) است. اگر مدل روی داده های آموزشی بسیار خوب عمل کند اما روی داده های اعتبارسنجی عملکردش به طور چشمگیری افت کند، نشانه ای قوی از بیش برازش است.